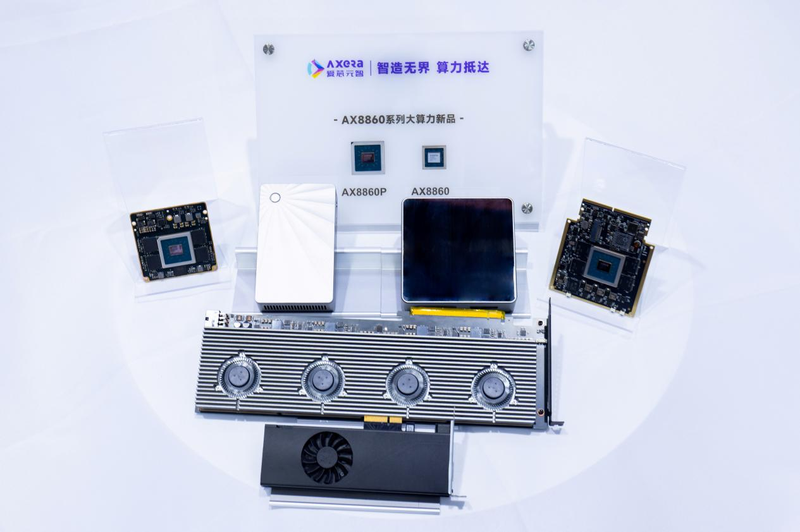
爱芯元智在工博会期间正式发布AX8860大算力边端AI芯片系列。新产品面向大模型在边缘和端侧的部署需求,提供256 TOPS混合精度算力、128 GB LPDDR5X内存和273 GB/s内存带宽,并支持FP4精度、AXLink级联及PCIe 5.0高速互联。围绕AX8860,爱芯元智还展示了元曦模组、AI推理卡及推理服务器等产品形态。
与传统视觉处理芯片不同,AX8860主要面向大模型推理和后端计算。随着模型推理从云端向企业、工厂及各类终端延伸,边缘AI芯片除了算力,还要考虑内存容量、推理效率、功耗、部署成本,以及模型能否稳定运行在具体业务中。
在接受采访时,爱芯元智创始人、董事长仇肖莘博士围绕AX8860的产品定义、工业AI落地和边缘计算的发展方向,分享了公司的思考。在她看来,边缘AI市场具有明显的场景碎片化特征,企业需要围绕真实需求搭建算力平台,并通过软硬件生态合作推动应用落地。
高算力之外,模型能否高效运行更重要
AX8860的产品定义始于2025年。仇肖莘介绍,当时团队在规划产品时,已经注意到大模型轻量化的趋势,过去需要更大参数规模的模型才能实现的推理效果,如今部分27B及更小规模的模型也能够满足不少应用需求。
与单纯追求峰值算力相比,爱芯元智更关注芯片能否在目标算力范围内运行有实际应用价值的模型,以及能否达到用户可以接受的推理速度。仇肖莘表示,在AX8860定义阶段,团队将8B、9B、27B等模型的原生支持作为重要目标,并将Token吞吐速度达到30 Token/s作为需求指标,再通过多轮仿真验证,确定芯片的算力与带宽规格。
AX8860芯片提供256 TOPS混合精度算力,原生支持FP4,并配备128 GB LPDDR5X内存,内存带宽达到273 GB/s。对于边缘侧大模型而言,算力只是影响推理表现的因素之一。随着模型规模扩大,参数、权重和中间数据的存取也会对推理效率产生影响,因此内存容量和带宽同样重要。
在采访中,仇肖莘特别提到了Prefill和Decode两个阶段的区别。前者主要依赖计算能力,后者则更受内存带宽影响。按照她的解释,AX8860与国际头部产品相比,计算能力已基本持平,在带宽方面则具备一定优势。公司希望通过算力、内存和功耗的整体平衡,避免单项指标突出、实际运行却受到其他环节制约的问题。
在多芯片扩展方面,AX8860支持AXLink级联技术。通过芯片互联,客户可以根据业务需要扩展算力,并实现多芯片协同下的内存池化。相比单纯增加芯片数量,这种扩展方式还需要兼顾数据传输效率和访问延迟。芯片同时支持64路视频解码和16路视频编码,可用于多路视频分析与大模型推理相结合的应用。
不过,产品发布并不意味着所有指标已经达到最终状态。仇肖莘透露,AX8860在本次发布前刚刚完成回片,基础Bring-Up调试已经完成,但软件栈仍在持续优化。从芯片回片到量产还需要一定周期,现阶段公布的数据仍有进一步提升的空间。
对边缘AI芯片而言,产品竞争力最终需要落到实际模型和具体负载上。峰值算力决定了硬件能力的上限,而模型适配、内存访问效率和软件优化,则共同影响客户真正能够使用的推理性能。
从工业视觉到具身智能,AI必须在现场完成闭环
工业是AX8860重点面向的应用方向之一。与云端AI应用相比,工业现场对实时响应、运行稳定性和系统协同有着更加具体的要求。
仇肖莘以生产线上的缺陷检测为例介绍了边缘AI的应用方式。一条流水线上通常设置多个工位和检测点,工业相机需要以较高分辨率获取图像,在很短的时间内识别零部件缺陷,并将检测结果传递给控制端。一旦确认存在缺陷,就需要及时下发分流指令。如果识别和决策过程耗时过长,即使模型具有较高的识别准确率,也可能错过生产线上的有效处理时机。
针对这类需求,爱芯元智采用了前端视觉处理与后端边缘计算相结合的方案。
在前端,公司已有面向智能视觉处理的产品AX8910,可支持1200万至1600万像素的高分辨率工业检测相机,单颗芯片提供最高18 TOPS算力,部分检测推理可以直接在本地完成。随后,检测结果传递给边缘计算设备,由后者进一步处理和决策。A8860担任的则是这一重要角色。
在本届工博会上,爱芯元智还与合作伙伴原力灵机展示了具身智能应用。原力灵机携自研DM0.5通用具身大脑亮相,演示了接口插拔质检、通用工业插入和灵巧手柔性切削等任务。据介绍,DM0.5依托爱芯元智的大算力平台完成模型推理,展示了边缘算力在精密制造、工业质检及柔性加工等场景中的应用潜力。
仇肖莘认为,工业AI从技术验证走向实际部署,瓶颈并不只是算力。首先,工业产线通常对时延有严格要求;其次,不同生产场景使用的模型存在差异,客户需要能够快速完成模型部署、适配,并将其接入现有生产流程;此外,工业设备的长期稳定运行也是不可忽视的要求。
“倘若部署任意一个垂类模型都需要数月甚至一年周期,商业化落地就无从谈起。”她表示。
为降低这一门槛,爱芯元智持续建设软件工具链和模型生态。仇肖莘透露,对于部分新模型,公司能够在一两天内完成部署,较复杂的模型则可能需要一至两周。截至目前,公司已经完成260多个模型的部署,并已在Github上将这些开源代码对外开放。
2026年1月,工业和信息化部等八部门发布《“人工智能+制造”专项行动实施意见》,提出推动边缘计算服务器部署,促进云边端算力协同,并将工业视觉智能检测、智能排产调度、设备预测性维护等列为重点应用方向。政策强调根据工业低时延需求,在边缘端部署轻量化模型,为工业AI应用进一步落地提供了方向指引。
对于芯片厂商而言,这也意味着竞争范围正在扩大。硬件需要提供足够的算力和稳定性,软件工具需要降低模型迁移成本,而最终应用还需要与工业设备、控制系统和生产流程形成有效衔接。只有这些环节共同工作,推理能力才有机会转化为生产效率。
边缘AI市场仍然碎片化,平台与生态决定长期空间
在仇肖莘看来,边缘AI与云端计算的一个重要区别,在于应用需求的碎片化。
云端计算可以通过通用性较强的芯片覆盖多种任务,但边缘侧的应用差异更大。从视频数据采集、智能驾驶到工业推理、机器人,不同场景对算力、功耗、接口、可靠性和成本的要求并不相同。试图用一颗芯片覆盖所有应用,既不现实,也未必具备成本优势。
爱芯元智的做法,是提炼不同场景所需要的共性技术,形成包含ISP、AI ISP、NPU、视频编解码及配套小型IP在内的技术体系,再根据不同应用需求进行组合,开发相应的专用芯片。
仇肖莘将这一模式与公司的平台型定位联系起来。爱芯元智首先切入视频数据采集市场,随后进入智能驾驶领域,并从2025年开始拓展大算力边缘AI推理芯片领域。她表示,公司正在关注机器人这一潜在的第四条增长曲线,但目前机器人行业的出货规模仍然有限,真正进入规模化阶段的时间还存在不确定性。
在她看来,机器人涉及的计算需求也并非单一形态。机器人“大脑”需要较强的计算能力,以支持复杂模型和实时控制;“小脑”需要适度算力以及丰富的外设接口;视觉模组则负责环境感知与数据采集。不同环节的需求存在差异,但爱芯元智可以通过现有产品和技术积累,为这些方向提供相应的芯片支持。
与机器人相比,企业本地AI部署也是仇肖莘看好的应用方向。随着大模型和智能体逐步进入企业研发、运营和管理流程,一部分数据并不适合直接上传云端。对于涉及研发资料、经营信息等敏感内容的任务,本地推理能够在一定程度上减少数据外传的需求。
这类应用不一定需要运行参数规模极大的模型。例如,企业内部报表生成、知识检索和部分日常办公任务,可以通过适当规模的模型完成。未来,推理卡、硬件模组和智能体盒子等形态,都有可能成为企业部署本地AI的载体。
仇肖莘表示,公司始终坚持芯片厂商的Tier 2定位,主要提供底层芯片和算力平台,不直接进入上层算法开发。她认为,这样可以让算法公司、系统集成商及其他合作伙伴在统一的硬件平台上开发产品,而不必担心芯片厂商未来成为自己的直接竞争者。
随着大模型开始进入工厂、企业和各类智能设备,边缘AI的需求可能进一步扩展,但不同场景的商业化节奏不会完全一致。对于芯片厂商来说,如何在成本、性能、功耗和易用性之间找到合适的平衡,并让客户能够持续、稳定地部署应用,将是决定产品能否从技术能力转化为市场收入的关键。